
Парсинг сайтов для бизнеса: как собирать данные легально и без банов
Парсинг (web scraping) - это автоматический сбор данных с сайтов: цены конкурентов, остатки на маркетплейсах, объявления, контакты, отзывы. Звучит просто: «напишите скрипт, который скачает страницы». На практике разница между скриптом «на коленке» и парсером, который работает годами без присмотра, - это десятки решений про прокси, лимиты, структуру данных и законность. Ниже - что делает парсинг рабочим инструментом для бизнеса, а не источником банов и юридических рисков.
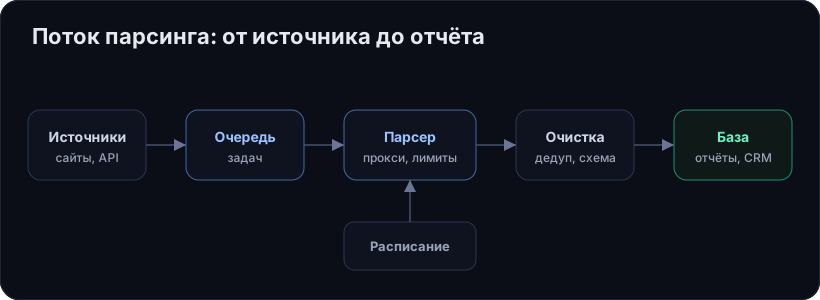
Где парсинг реально помогает
Парсинг приносит деньги, когда данные меняются часто, а руками их собирать дорого:
- Мониторинг цен конкурентов - динамическое ценообразование на маркетплейсах и в рознице.
- Остатки и ассортимент - отслеживание наличия товаров у поставщиков и конкурентов.
- Лидогенерация - сбор компаний и контактов из каталогов и справочников под холодные продажи.
- Контент и аналитика - отзывы, рейтинги, вакансии, новости отрасли в один дашборд.
- Наполнение каталога - характеристики и фото товаров при заводе нового ассортимента.
Законно ли это
Короткий ответ: сбор публично доступных данных в большинстве юрисдикций допустим, но есть красные линии. Парсинг - это не «всё, что не запрещено». На что смотреть:
- Персональные данные. Сбор ФИО, телефонов, email подпадает под закон о персональных данных (152-ФЗ, GDPR). Публичность не отменяет требований к обработке.
- Авторское право. Тексты, фото, описания - объекты авторских прав. Сбор для анализа - одно, перепубликация один-в-один - нарушение.
- Условия использования сайта. Запрет на автоматический сбор в ToS - это договорный риск, особенно если вы регистрировались на сервисе.
- Нагрузка. Агрессивный парсинг, кладущий чужой сайт, - это уже про неправомерный доступ, а не про сбор данных.
Практическое правило: собирайте только публичные факты, не ломайте защиту, не создавайте нагрузку и не перепубликуйте чужой контент дословно. Если данные за логином или есть капча «не пускать роботов» - это явный сигнал, что вас не звали.
Почему вас банят и как этого избежать
Антибот-системы (Cloudflare, DataDome и аналоги) ловят парсеры по поведению, а не по «злому умыслу». Чтобы сбор был стабильным, парсер должен выглядеть как обычные пользователи, а не как один айпишник, выкачивающий 10 000 страниц в минуту.
Лимиты и пауза между запросами
Самая частая причина бана - скорость. Ставьте задержки (0.5–3 секунды между запросами на один домен), ограничивайте параллелизм, соблюдайте robots.txt и Crawl-delay. Медленный парсер, который работает, лучше быстрого, который умер через час.
Ротация прокси и User-Agent
Для объёмов - пул прокси (резидентные дороже, но реже банятся; датацентровые дешевле для лояльных сайтов). Меняйте User-Agent и заголовки на реалистичные. Не изобретайте странные комбинации - берите те, что реально шлют браузеры.
Headless-браузер только когда нужно
Если данные приходят обычным HTML - берите их HTTP-запросом (быстро и дёшево). Headless-браузер (Playwright, Puppeteer) нужен для сайтов на JavaScript и для обхода поведенческих проверок, но он в 10–50 раз ресурсозатратнее. Не стреляйте из пушки по воробьям.
Сначала ищите API
Многие сайты под капотом дёргают свой же JSON-API (видно во вкладке Network). Часто проще и стабильнее собирать данные оттуда, чем парсить HTML, который меняется при каждом редизайне.
Инструменты: чем парсят в 2026
| Инструмент | Когда брать |
|---|---|
| requests + BeautifulSoup / lxml | Статический HTML, небольшие и средние объёмы. Быстро, просто, дёшево. |
| Scrapy | Большие проекты: очереди, ретраи, пайплайны, экспорт из коробки. |
| Playwright / Puppeteer | JS-сайты, авторизация, поведенческие антибот-проверки. |
| n8n + HTTP Request | Лёгкий сбор и сразу автоматизация: разложить в таблицу, CRM, Telegram. |
Для большинства бизнес-задач связка Python (Scrapy/requests) для сбора + n8n для доставки данных закрывает 90% сценариев.
Данные: собрать - половина дела
Сырые HTML-страницы бесполезны. Ценность появляется после обработки.
Нормализация
Цены приводим к одной валюте и формату, даты - к ISO, названия товаров - к единому виду. «1 999 ₽», «1999.00», «1 999 руб.» должны стать одним числом, иначе сравнивать нечего.
Дедупликация
Один товар на сайте встречается в каталоге, в поиске и в акциях. Без ключа дедупликации (артикул, URL, хэш характеристик) вы получите три записи об одном SKU и кривую аналитику.
Хранение
Для большинства проектов - PostgreSQL: историзация цен, индексы, удобные выборки. Для разовых задач хватит выгрузки в Google Sheets или CSV. Главное - хранить историю, а не только последний снимок: ценность мониторинга именно в динамике.
Мониторинг самого парсера
Сайты меняют вёрстку, и парсер тихо начинает собирать пустоту. Без присмотра вы узнаете об этом, когда в отчёте окажутся нули. Минимум, который нужен:
- Алерты на пустые результаты - если собрано меньше N записей, чем обычно, шлём уведомление в Telegram.
- Проверка структуры - если исчез ожидаемый селектор, парсер падает осознанно, а не пишет
null. - Логи и метрики - сколько страниц, сколько ошибок, сколько забанено, время ответа.
- Расписание с ретраями - упавшую задачу повторяем, а не теряем.
Сколько это стоит в эксплуатации
Грубая оценка для среднего проекта мониторинга (несколько источников, обновление раз в сутки):
- VPS под парсер и базу - стоимость недорогого сервера в месяц;
- Прокси - от нескольких долларов (датацентровые) до десятков (резидентные) в зависимости от объёма;
- Headless-браузер при больших объёмах - основная статья по CPU/RAM, закладывайте запас;
- Поддержка - главная скрытая статья: вёрстка источников меняется, и парсер требует правок.
Когда нанять подрядчика, а когда сделать самим
Собрать данные с пары простых сайтов разово может и один разработчик за день. Где люди обжигаются:
- «запустили и забыли» - без мониторинга парсер тихо собирает мусор после редизайна источника;
- сэкономили на прокси и лимитах - поймали бан и потеряли доступ к источнику;
- не продумали нормализацию - данные есть, а сравнивать их нельзя;
- залезли в персональные данные и контент без оглядки на закон.
Если эти задачи есть кому решать внутри - отлично, делайте сами. Если нужен парсер «под ключ» с базой, расписанием и мониторингом - посмотрите нашу Python-разработку или автоматизацию маркетплейсов.
Чек-лист перед запуском парсера
- Проверили законность: только публичные факты, без персональных данных и дословной перепубликации.
- Нашли источник данных: API лучше HTML, HTML лучше headless-браузера.
- Настроили лимиты, паузы и ротацию прокси/User-Agent.
- Заложили нормализацию и дедупликацию данных.
- Выбрали хранилище с историзацией, а не «последний снимок».
- Подключили алерты на пустые результаты и поломку структуры.
- Завели расписание с ретраями и регламент правок при редизайне источника.
Хороший парсер - это не «скрипт, скачивающий страницы», а инженерный конвейер: источник, сбор с уважением к чужому сайту, очистка, хранение, мониторинг и регламент обновления. Если все семь пунктов выше зелёные - проект готов к проду. Если нет - лучше довести их, а потом запускать.
Самый частый рабочий сценарий сбора данных - следить за собственными поставщиками: остатки, пропавшие позиции и подорожания. Разобран отдельно в статье про мониторинг наличия у поставщиков.
Не готовы обсуждать проект? Оцените выгоду сами: калькулятор ROI автоматизации - 1 минута, без контактов. Или заберите чек-лист «Что автоматизировать первым».