
RAG-ассистент для поддержки: как сделать, чтобы не врал
RAG (Retrieval-Augmented Generation) - это когда LLM отвечает не «из головы», а на основе ваших документов. На бумаге звучит как волшебная палочка для поддержки: загрузил FAQ, базу знаний и инструкции - получил круглосуточного ассистента. На практике 90% «слепленных за вечер» RAG-ботов либо врут, либо отвечают вокруг да около. Ниже - что делает RAG-ассистента рабочим инструментом, а не игрушкой для презентации.
Где RAG реально помогает, а где нет
RAG работает, когда:
- есть структурированная или хотя бы причёсанная база знаний (FAQ, инструкции, регламенты);
- вопросы клиентов повторяются, и ответы на них есть в документах;
- ответ можно сформулировать на основе текста, без сложных вычислений или обращений к live-данным.
RAG не работает, когда:
- нужен ответ по личным данным клиента (баланс, статус заказа) - это уже tool-calling к CRM/ERP, а не поиск по тексту;
- знаний в документах нет, и клиенту нужен живой эксперт;
- вы ждёте, что LLM «угадает» правильный ответ - нет, не угадает.
Архитектура RAG в одном абзаце
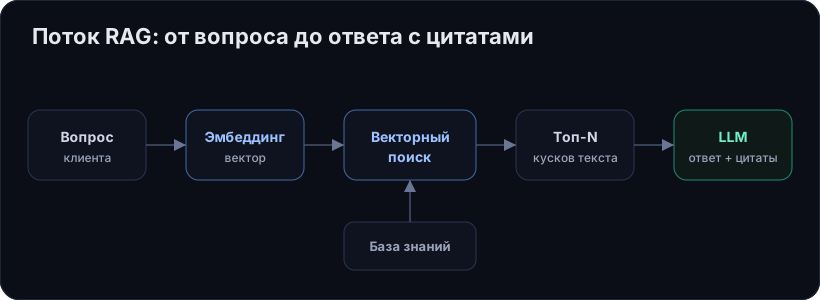
Поток выглядит так: вопрос → эмбеддинг → векторный поиск по базе → топ-N кусков текста → отдаём в LLM как контекст → ответ с цитатами. Всё. Дальше - детали, и именно в них живёт разница между «отвечает по делу» и «галлюцинирует через раз».
Источники: что грузим в базу
Хороший RAG начинается не с выбора LLM, а с того, что вы кладёте в индекс.
- FAQ и Help Center - лучший материал: структурированный, короткий, по теме.
- Регламенты и инструкции - годятся, но требуют чистки от внутренней лексики.
- История тикетов - мощный источник, но нужна разметка: какие тикеты решены правильно, какие - нет.
- Презентации и PDF - самое муторное: таблицы рассыпаются, картинки игнорируются.
- Сайт и блог - годится, если контент структурирован, и нет дубликатов между разделами.
Правило, которое мы повторяем клиентам: мусор внутри = мусор на выходе. RAG не превратит хаотичную базу в порядок. Сначала прибрать источники, потом строить ассистента.
Чанки: нарезка решает всё
Чанк (chunk) - это кусок текста, который попадёт в индекс как «единица знания». Слишком маленькие - теряется контекст. Слишком большие - LLM получает много шума и хуже фокусируется.
Размер
Рабочий диапазон - 200–800 токенов на чанк (это ~150–600 русских слов). Меньше - для коротких FAQ. Больше - для регламентов с длинными контекстами. С overlap 10–15% между соседними чанками, чтобы не терять связи на стыках.
Структурная нарезка лучше посимвольной
Не «режем каждые 500 токенов», а нарезаем по структуре документа: по заголовкам H2/H3, по пунктам списка, по абзацам. Так каждый чанк остаётся осмысленным куском, а не оборванной мыслью.
Метаданные на каждом чанке
Минимум: source (документ), section (раздел), updated_at, url (для цитирования в ответе). По ним можно фильтровать поиск и показывать клиенту, откуда ответ.
Эмбеддинги: что выбрать
Эмбеддинг - это векторное представление текста. От него зависит, насколько хорошо поиск найдёт нужный чанк по вопросу. Для русского языка в 2026 актуальны:
- OpenAI text-embedding-3-large/small - стандарт по умолчанию, хорошо работает с русским, дёшев.
- Cohere embed-multilingual-v3 - отличное качество на мультиязычных корпусах.
- BGE-M3, multilingual-e5 - open-source модели, которые можно гонять локально. Качество близко к коммерческим на русском.
Для большинства задач берём OpenAI или open-source на своём сервере. Open-source - когда есть требование «никаких данных за пределы периметра».
Векторное хранилище
Под капотом - обычно PostgreSQL с pgvector (если данные и так в PG), либо специализированные: Qdrant, Weaviate, Milvus. Для проектов до миллиона чанков pgvector хватает с запасом и не требует отдельного сервиса.
LLM: что отвечает
В 2026 рабочий выбор:
- GPT-4o / GPT-4.1 - дорого, но надёжно следует инструкциям и редко галлюцинирует на нормальном контексте.
- Claude 3.5/4 Sonnet - лучше в длинных контекстах и инструкциях «не выдумывай».
- YandexGPT - для проектов, где данные обязаны оставаться в РФ.
- Open-source (Llama 3, Mistral) - на своих GPU, когда нужен полный контроль.
Для большинства проектов поддержки разумно не экономить на LLM: разница между «правильно ответил» и «правильно ответил, но дёшево» в проде окупает себя.
Как защититься от галлюцинаций
Жёсткий промпт
В системном промпте - прямое правило: «отвечай только на основе предоставленных документов. Если ответа в документах нет - скажи “не знаю” и предложи передать вопрос менеджеру». Это не магия, но снижает выдумывание в разы.
Цитирование источников
Заставляйте LLM приводить ссылку или название документа на каждый факт. Если LLM не может процитировать - значит, выдумал. Заодно это даёт клиенту контроль: можно перейти и проверить.
Порог релевантности
Если топ-N чанков по cosine similarity ниже порога (например, 0.7) - не отвечаем сами, а отдаём оператору. Не дёшево, но честно.
Re-ranking
После векторного поиска - пропускаем топ-20 через cross-encoder (Cohere Rerank, BGE-Reranker), берём топ-5. Качество ответов растёт заметно, добавляет ~200 мс на запрос.
Fallback на оператора
Любой клиент в любой момент может попросить человека. Никаких «давайте я попробую помочь ещё раз». Кнопка «позвать менеджера» должна быть в каждом сообщении бота.
Метрики качества
Без метрик RAG-ассистент превращается в «ну вроде отвечает». Минимальный набор того, что нужно мерить:
- Hit rate - в каком % случаев нужный документ попал в топ-N поиска. Если меньше 80% - проблема в индексе, а не в LLM.
- Answer relevance - насколько ответ соответствует вопросу (оценивают люди или LLM-as-a-judge на сэмпле).
- Faithfulness - насколько ответ опирается на документы, без выдумок. Главная метрика против галлюцинаций.
- Deflection rate - % обращений, закрытых без оператора. Это бизнес-метрика, остальные - технические.
- CSAT - оценка пользователя после диалога (👍/👎 или 1–5).
Перед запуском - обязательно прогон оценочного набора из 50–200 типовых вопросов с эталонными ответами. После каждого изменения промпта или индекса - прогоняете тот же набор и смотрите, не уехало ли качество.
Сколько это стоит в эксплуатации
Грубая оценка для среднего проекта поддержки на ~1000 диалогов в месяц:
- Эмбеддинги (первичная индексация + пере-индексация раз в неделю) - единицы долларов в месяц;
- LLM (GPT-4o-уровень, ~3000 токенов в среднем на диалог) - $30–100/мес;
- Векторное хранилище (pgvector на VPS) - стоимость VPS;
- Рекомендуем держать запас в 30–50% от оценки на пиковые запросы.
Когда нанять подрядчика, а когда сделать самим
Сделать «RAG-ассистент по 200 страницам FAQ» сегодня может команда из 1–2 разработчиков за пару недель. Где люди обжигаются:
- «запустили и забыли» - без мониторинга качество тихо едет вниз;
- не настроили fallback на оператора - клиенты злятся;
- не выбрали метрики - нечем доказать руководству, что бот работает;
- не проложили процесс пополнения базы - за полгода знания устарели.
Если эти задачи есть кому решать внутри - отлично, делайте сами. Если нет - посмотрите наш RAG-агент под ключ или общую автоматизацию поддержки.
Чек-лист перед запуском RAG-ассистента
- База знаний почищена, без дубликатов и устаревших версий.
- Чанки нарезаны по структуре, не по символам, с метаданными.
- Эмбеддинги выбраны под язык и юрисдикцию.
- В промпте есть жёсткий запрет на выдумки и инструкция цитировать.
- Порог релевантности и fallback на оператора настроены.
- Есть оценочный набор из 50+ типовых вопросов и автопрогон метрик.
- Заведён процесс пополнения базы - кто и как добавляет новые документы.
Хороший RAG-ассистент - это не «накатили модель за вечер», а инженерный продукт с источниками, индексом, промптом, метриками и регламентом обновления. Если все семь пунктов выше - да, проект готов. Если нет - лучше довести их до зелёного, потом запускать.
Не готовы обсуждать проект? Оцените выгоду сами: калькулятор ROI автоматизации - 1 минута, без контактов. Или заберите чек-лист «Что автоматизировать первым».